Da Dual-GAM à ADArena: consolidando a arquitetura da IC
Dando continuidade ao último post, nele tentei deixar mais explícito o que essa iniciação científica está tentando investigar. A conclusão foi que o projeto não deveria ser tratado apenas como um experimento com dois modelos competindo, mas como um ambiente experimental para pesquisa em defesa adaptativa baseada em aprendizado adversarial.
A primeira versão da arquitetura cumpria o seu objetivo: tirar o experimento do notebook. Mas, antes de pensar em qualquer expansão, era necessário responder uma pergunta mais básica:
O que já existe é confiável o suficiente para servir como uma ferramenta de experimentação?
Foi a partir dessa pergunta que começou uma revisão da arquitetura. O resultado desse processo é o que estou considerando como v1.7, a consolidação da linha 1.x.
Este post não é uma análise dos resultados produzidos por essa versão. Isso fica para o próximo texto. Aqui, quero registrar principalmente o que mudou, por que mudou e como essas alterações aproximam o projeto da ideia de uma ferramenta experimental.
De Dual-GAM para ADArena
Desde o início, o projeto vinha sendo chamado de Dual-GAM. O nome surgiu quando a proposta ainda estava muito associada à ideia de dois modelos adversariais competindo entre si: uma "GAN atacante" e uma "GAN defensora".
**Só por curiosidade, o nome foi concebido por um erro de digitação. Escrevi GAM no lugar de GAN.
Só que, olhando para a implementação atual, essa descrição não é exatamente correta.
O atacante funciona como um gerador neural de perturbações adversariais. Ele recebe amostras reais de DDoS e aprende modificações capazes de reduzir a probabilidade de detecção. O defensor, por outro lado, é essencialmente um classificador binário.
Ou seja, não temos duas GANs clássicas competindo entre si.
Mais importante do que a nomenclatura dos modelos, entretanto, é que eles deixaram de definir o projeto inteiro.
A arquitetura que quero construir deve permitir que diferentes estratégias ocupem esses papéis:
atacante
   ↓
estratégia de geração adversarial

defensor
   ↓
modelo ou mecanismo de detecção

rede
   ↓
condições experimentais

controle
   ↓
observação, decisão e resposta
Se amanhã o atacante deixar de ser um modelo neural e passar a utilizar outra técnica, a arquitetura não deveria perder sua identidade.
Por isso, decidi dar um nome próprio à ferramenta:
ADArena — Adaptive Defense Arena
"Arena" representa melhor a ideia atual: um ambiente onde estratégias ofensivas e defensivas podem interagir sob condições controladas, ser observadas e comparadas.
O repositório continuará com o nome Dual-GAM, principalmente para não quebrar links e referências dos posts anteriores. A mudança é sobre a identidade da ferramenta, não sobre apagar a história do projeto.
Antes de expandir, consolidar
Quando revisei a primeira implementação, a tentação mais fácil seria continuar adicionando componentes.
Já existiam várias ideias: implementar a camada SDN, gerar tráfego legítimo mais complexo, fechar o feedback online, testar novos ataques e até explorar honeypots.
Mas isso criaria um problema.
Se a infraestrutura atual ainda tinha falhas metodológicas, logging limitado e pouca observabilidade, aumentar sua complexidade só tornaria mais difícil descobrir o que estava realmente acontecendo.
A prioridade da linha 1.x passou a ser outra:
corrigir
   ↓
medir
   ↓
validar
   ↓
só então expandir
A primeira parte dessa revisão começou pelo ponto mais básico de qualquer experimento de aprendizado de máquina: os dados.
Corrigindo o pipeline de dados
O primeiro problema encontrado foi um data leakage no pré-processamento.
Na implementação inicial, o StandardScaler era ajustado antes da separação entre treino e teste.
O fluxo era aproximadamente:
Dataset
   ↓
normalização
   ↓
split treino/teste
Isso significava que estatísticas do conjunto que posteriormente seria usado para avaliação já tinham influenciado a normalização.
A correção foi alterar a ordem:
Dataset
   ↓
limpeza e encoding
   ↓
split
   ↓
fit do scaler apenas no treino
   ↓
transform nos demais conjuntos
Parece uma alteração pequena, mas ela muda a validade dos experimentos. Se a intenção é comparar versões do defensor e medir adaptação, o conjunto utilizado para avaliar o modelo não pode participar indiretamente de sua preparação.
A partir dessa correção, os resultados antigos deixaram de ser tratados como equivalentes aos novos.
Não basta separar: é preciso verificar
Corrigir o scaler remove uma fonte de leakage, mas ainda existe outro problema possível: duplicatas.
Duas linhas idênticas podem terminar em conjuntos diferentes. Formalmente os índices seriam distintos, mas, na prática, o modelo poderia ser avaliado sobre uma amostra que já viu.
Por isso, o Preprocessor passou a realizar uma auditoria explícita.
Além de verificar duplicatas exatas, a implementação passou a checar interseções entre treino, validação e teste.
A divisão também deixou de ser apenas treino/teste. Agora existem três conjuntos com responsabilidades diferentes:
treino
   ↓
aprendizado dos modelos

validação
   ↓
avaliações durante o experimento

teste
   ↓
avaliação final reservada
A ideia aqui é simples: não assumir isolamento, mas verificá-lo.
Isso também prepara (em teoria) a arquitetura para protocolos experimentais mais rigorosos no futuro, especialmente quando começarmos a comparar modelos e estratégias diferentes.
Uma execução precisa poder ser reproduzida
Outro problema da implementação inicial era que rodar o mesmo experimento duas vezes não significava necessariamente executar o mesmo experimento.
A arquitetura passou a definir seeds para Python, NumPy e PyTorch e a registrar informações da execução, como hiperparâmetros e configuração experimental.
Cada treinamento também passou a possuir uma identidade própria:
run_YYYYMMDD_HHMMSS_seed42
Esse run_id organiza checkpoints, métricas, gráficos e outros artefatos.
O objetivo é que uma execução deixe de ser apenas uma sequência de mensagens no terminal e passe a ser uma unidade experimental que pode ser recuperada e analisada posteriormente.
Ainda existe espaço para evoluir essa parte (principalmente centralizando todos os parâmetros em uma configuração única), mas o princípio já está implementado: o estado do experimento precisa ser explícito.
Medir adaptação exige medir antes e depois
Uma das limitações mais importantes da primeira versão estava na forma como o treinamento era observado. Era possível acompanhar loss, accuracy e taxa de evasão, mas essas métricas não respondiam de forma tão clara à pergunta que o ciclo adversarial deveria investigar.
Se um atacante encontra uma variante capaz de evadir o defensor e depois o defensor é retreinado com essa variante, a comparação mais direta é:
A_n × D_(n-1)
       ↓
evasão antes da adaptação

A_n × D_n
       ↓
evasão depois da adaptação
Por isso, o treinamento passou a registrar explicitamente as duas avaliações.
Isso parece óbvio depois de implementado, mas muda bastante a leitura do experimento. Em vez de olhar apenas para "como terminou a rodada", conseguimos observar diretamente o efeito da adaptação sobre o mesmo atacante.
Também ampliamos as métricas do defensor com: Precision, Recall, F1, FPR, FNR, ROC-AUC e matriz de confusão.
Para o atacante, além da evasão, também passamos a registrar informações sobre a perturbação produzida.
Checkpoints deixaram de ser apenas backups
Outro ponto que mudou bastante foi o papel dos checkpoints.
Na implementação inicial, a execução seguia essencialmente uma política fixa: selecionar o melhor atacante e colocá-lo contra o defensor imediatamente anterior à sua adaptação.
Ela continua sendo a escolha padrão, já que faz sentido como demonstração. Mas ela esconde uma dinâmica adversarial.
Se cada rodada produz um atacante e um defensor diferentes, preservar esses estados permite fazer perguntas que seriam impossíveis olhando apenas para os modelos finais.
Por isso, os checkpoints passaram a ser salvos por rodada. Ao final do treinamento, a arquitetura consegue avaliar uma matriz:
A1..An × D0..Dn
Em outras palavras, atacantes antigos podem ser avaliados contra defensores novos e vice-versa. Basta apenas que o usuário especifique qual atacante e qual defensor ele quer.
Essa matriz não serve apenas para escolher "o melhor modelo". Ela permite observar se um defensor continua robusto contra estratégias anteriores ou se apenas aprendeu a responder ao atacante mais recente.
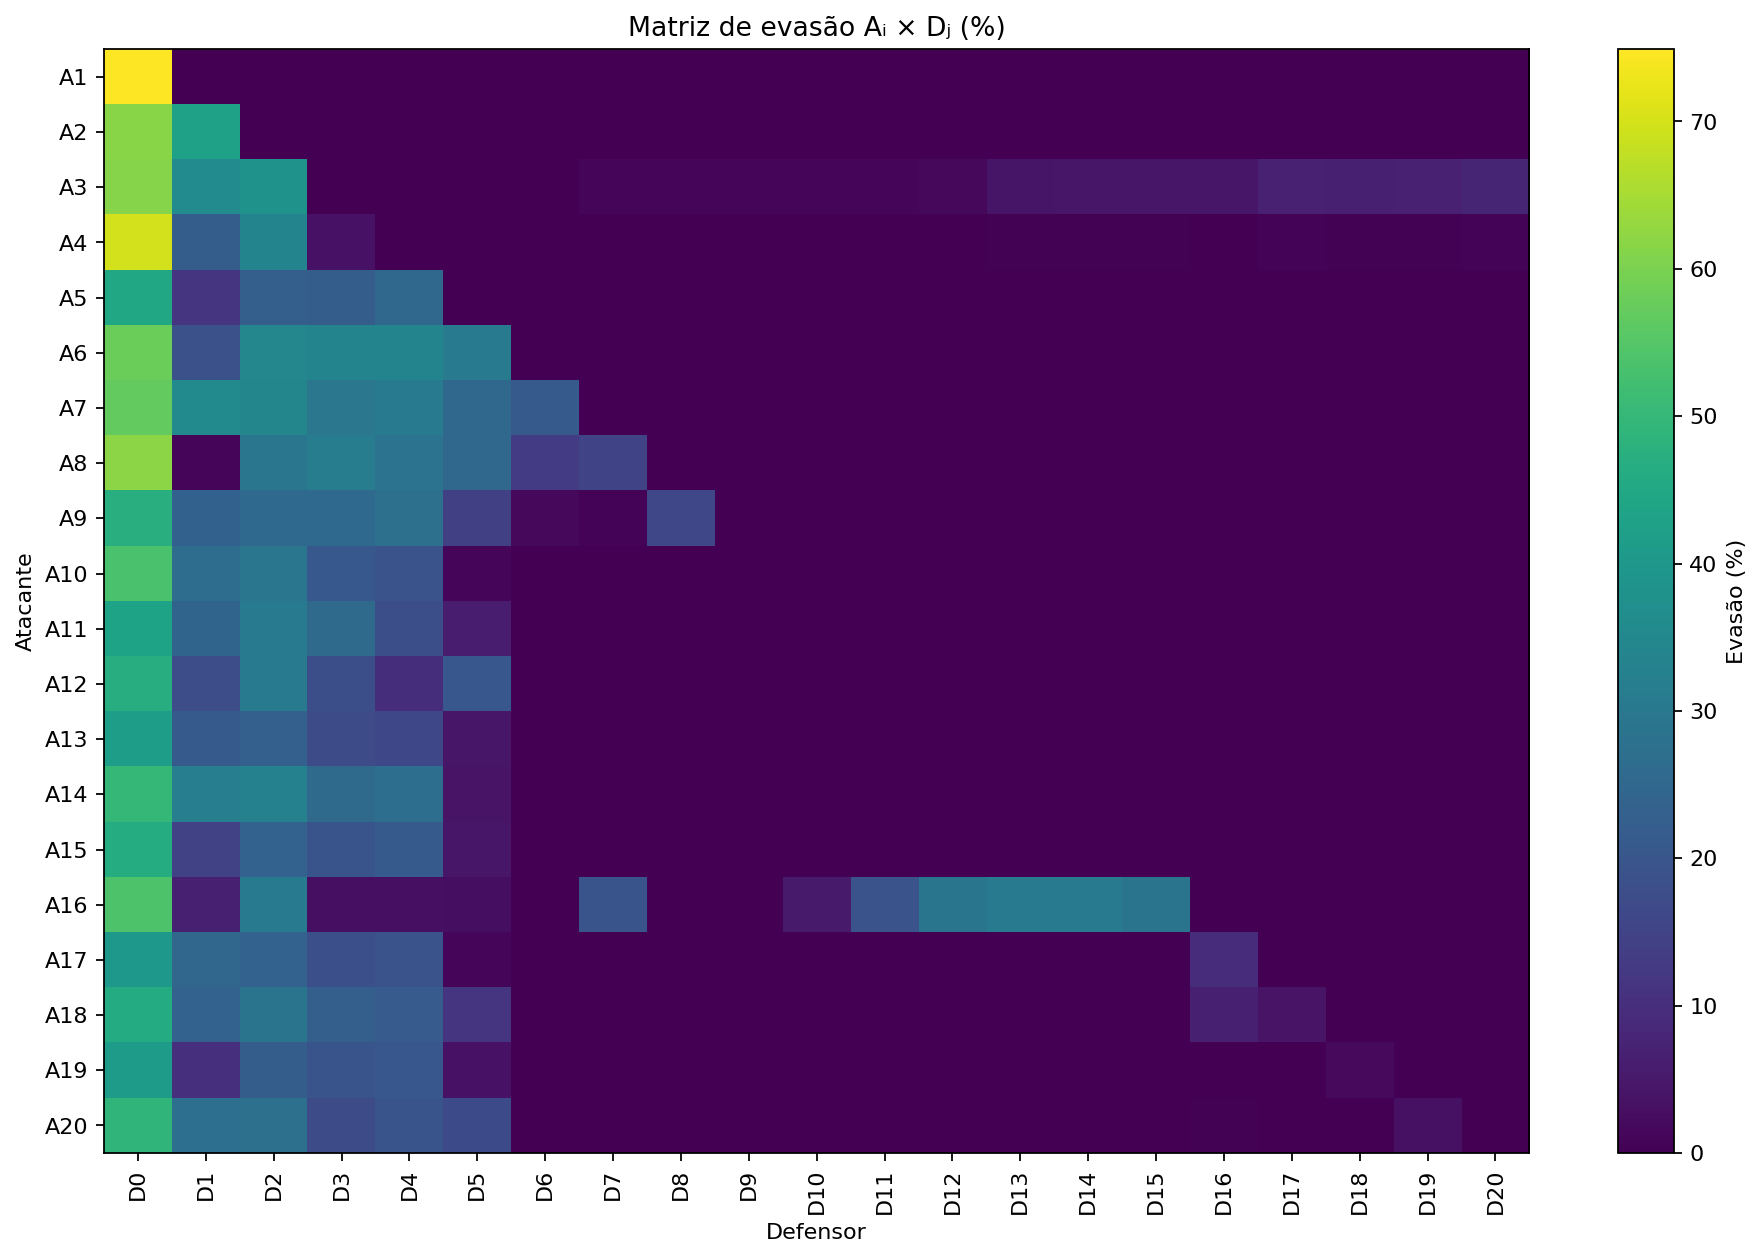 (heatmap de um dos treinos realizados)
A interpretação desses resultados merece uma discussão própria. Aqui, o ponto importante é que a arquitetura passou a preservar a história do experimento, em vez de guardar apenas seu estado final.
Resultados que não dependem do terminal
Esse foi outro problema que apareceu durante os primeiros posts. Os logs eram úteis para debugging, mas ruins para análise.
Uma execução longa produzia centenas de linhas:
ataque
↓
sender
↓
resultado
↓
próximo ataque
Encontrar um padrão depois significava voltar ao terminal, copiar trechos e reconstruir manualmente tabelas. A solução foi separar duas coisas.
O logging detalhado continua existindo, porque é importante para acompanhar o comportamento dos componentes.
Mas a execução também passou a gerar resultados estruturados.
Hoje um treinamento produz artefatos como:
summary.json
attacker_metrics.csv
defender_metrics.csv
matriz_checkpoints.csv
gráficos
checkpoints
O comando results exporta esses artefatos do volume persistente para o diretório local do projeto.
Isso parece uma melhoria de conveniência, mas existe uma razão metodológica por trás: a análise deve partir dos dados produzidos pelo experimento, e não da interpretação manual da saída do terminal.
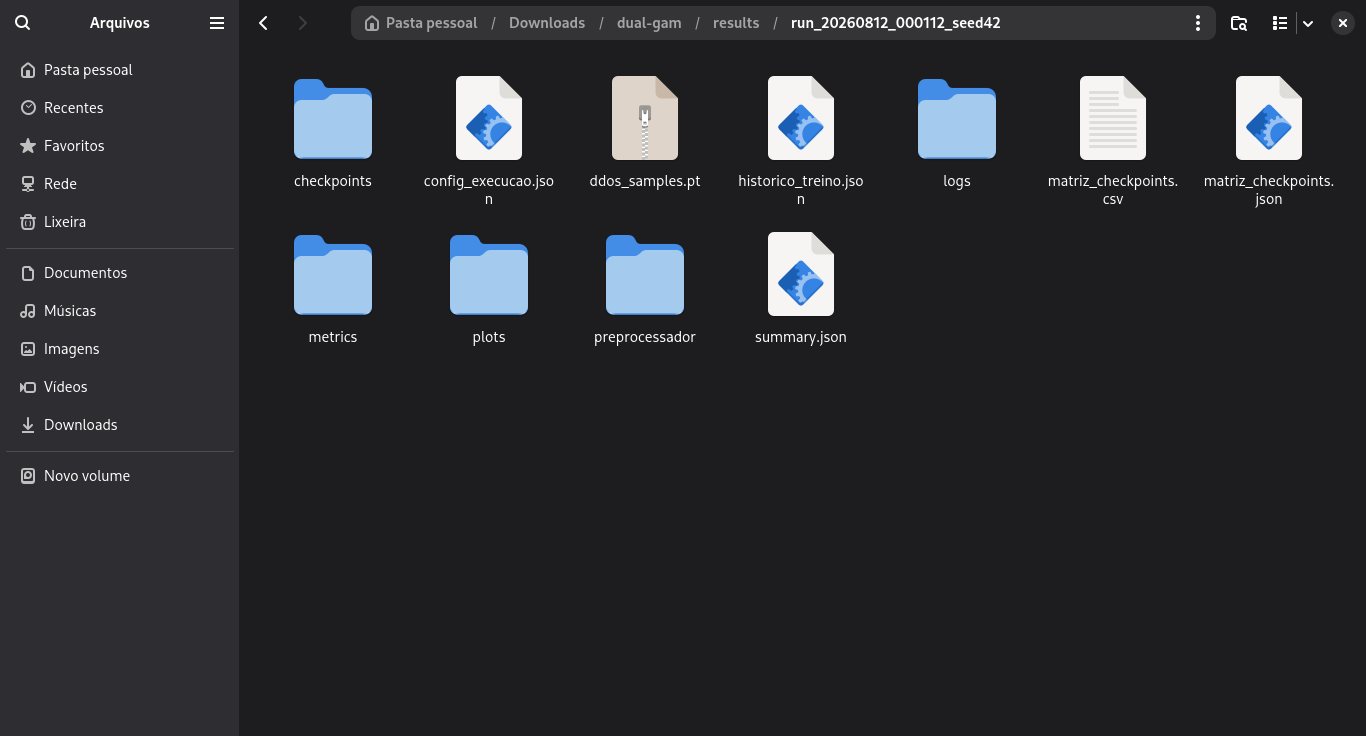 (print do que é gerado em results)
O Translator precisava deixar de aceitar qualquer coisa
A ponte entre o espaço de features e a rede sempre foi uma das partes mais delicadas da arquitetura.
O atacante não gera pacotes diretamente. Ele perturba um vetor com features do CIC-IDS2017.
Depois, o Translator tenta transformar parte dessas features em parâmetros que o Sender consegue utilizar.
Na primeira implementação, isso era bastante heurístico.
Existiam índices fixos para localizar features e algumas correções eram permissivas demais. Um exemplo era utilizar abs() para converter valores negativos em positivos.
O problema é que um valor fisicamente impossível não se torna automaticamente válido apenas porque seu sinal foi invertido.
A revisão do Translator seguiu outra ideia:
features
   ↓
desnormalização
   ↓
validação de consistência
   ↓
AttackParams
O mapeamento passou a utilizar os nomes das features sempre que possível, em vez de depender apenas de posições hardcoded.
Valores inválidos passaram a ser identificados explicitamente.
Também começaram a ser verificadas relações entre features que não deveriam ser tratadas como independentes. PPS, BPS e tamanho médio de pacote, por exemplo, precisam manter alguma coerência entre si.
Essa alteração introduziu uma distinção importante na arquitetura:
evasão matemática
        ≠
tradução válida
Um vetor pode enganar o defensor e ainda assim ser rejeitado pelo Translator.
Essa diferença será importante no próximo post, quando eu olhar para os resultados produzidos por essa versão.
Um problema descoberto no dry-run
A revisão do Translator revelou outro problema.
Inicialmente, mesmo quando o Translator identificava que uma amostra era inválida, ela ainda podia chegar ao Sender.
Ou seja:
evadiu o defensor
      ↓
Translator: inválido
      ↓
Sender mesmo assim
O próprio dry-run deixou isso evidente.
Esse comportamento não fazia sentido para o protocolo experimental.
Se o Translator existe justamente para separar vetores traduzíveis daqueles que violam as regras atuais de consistência, o Sender não deveria receber os rejeitados.
O Controller foi alterado para tornar essa fronteira explícita:
gerado
   ↓
evadiu?
   ↓
Translator
   ↓
válido?
├── não → rejeita e registra
└── sim → Sender
Depois da correção, a execução passou a registrar separadamente:
vetores gerados
evasões matemáticas
traduções válidas
traduções rejeitadas
execuções enviadas ao Sender
Isso é um bom exemplo de uma mudança que não surgiu porque estava prevista no roadmap, mas porque a própria instrumentação tornou um problema visível.
O Sender também precisava medir o que realmente fez
Outro ponto revisto foi a forma como o Sender reportava a execução.
Receber um AttackParams e terminar sem exceções não significa necessariamente que o tráfego produzido corresponde ao tráfego solicitado.
Por isso, o Sender passou a distinguir parâmetros desejados e valores observados durante sua própria execução.
Entre as informações registradas estão PPS, duração, quantidade de pacotes e throughput.
O motivo para isso é simples:
vetor adversarial
      ↓
AttackParams
      ↓
tráfego produzido
Cada transformação pode introduzir erro.
A arquitetura precisa medir essa diferença em vez de assumir que a tradução foi perfeita.
A execução em dry-run continua existindo para validar o pipeline sem transmitir pacotes. Já o modo de ataque produz tráfego apenas dentro do ambiente controlado da pesquisa.
Os resultados da execução real mostraram que medir essa diferença não era apenas uma precaução teórica. Mas novamente, essa discussão fica para o próximo post.
O Controller virou mais claramente um orquestrador
O Controller sempre foi um componente um pouco estranho da arquitetura.
Ele nasceu coordenando várias responsabilidades ao mesmo tempo: carregar modelos, selecionar checkpoints, gerar amostras, avaliar evasão, chamar Translator e Sender, registrar métricas e controlar ciclos.
Uma grande refatoração agora provavelmente atrapalharia mais do que ajudaria.
A estratégia adotada foi reduzir suas responsabilidades progressivamente.
Nesta consolidação, o principal foi fazer com que ele representasse corretamente o protocolo:
selecionar modelos
      ↓
gerar variantes
      ↓
avaliar evasão
      ↓
validar tradução
      ↓
executar
      ↓
registrar
Também corrigimos a persistência do histórico.
Antes, diferentes execuções podiam terminar compartilhando ou sobrescrevendo um mesmo arquivo.
Agora cada execução de rede possui seu próprio registro:
network_runs/
├── dry_run_demo_<timestamp>.json
├── dry_run_final_<timestamp>.json
└── attack_demo_<timestamp>.json
Isso é importante porque A1 × D0, A20 × D20 e qualquer outro par de checkpoints representam experimentos diferentes.
O histórico precisa preservar essa distinção.
Testar a ferramenta que produz os experimentos
Conforme a arquitetura começou a assumir um papel maior na pesquisa, outra preocupação ficou evidente.
Se vou utilizar a ferramenta para produzir evidências experimentais, preciso também ter alguma confiança de que seus invariantes estão sendo respeitados.
Foi criada uma suíte automatizada de testes cobrindo Preprocessor, Translator, Sender, Controller e integração do pipeline.
Mais importante do que a quantidade de testes são os comportamentos que eles tentam garantir.
Por exemplo:
o scaler não aprende com validação/teste

traduções inválidas não chegam ao Sender

dry-run não envia pacotes reais

históricos de execuções diferentes não são sobrescritos
A ideia não é provar que toda a arquitetura está correta apenas porque os testes passam.
É reduzir a quantidade de erros silenciosos capazes de contaminar um experimento.
Também integramos os testes ao próprio fluxo Docker, para que possam ser executados sem depender de uma instalação local específica do ambiente Python.
A v1.7
No início dessa revisão, eu estava numerando cada correção individualmente.
A v1.0 era a implementação inicial. Depois vieram v1.1, v1.2, v1.3 e outras alterações incrementais.
Com a quantidade de mudanças realizadas, acho mais útil tratar o estado atual como uma consolidação:
v1.7 — finalização da linha 1.x
A arquitetura atual pode ser entendida em três camadas:
┌──────────────────────────────┐
│ Aprendizado adversarial      │
│                              │
│ Atacante ↔ Defensor          │
│ Trainer / checkpoints        │
│ métricas / reporting         │
└──────────────┬───────────────┘
               ↓
┌──────────────────────────────┐
│ Controle                     │
│                              │
│ Controller                   │
│ Translator                   │
│ Sender                       │
└──────────────┬───────────────┘
               ↓
┌──────────────────────────────┐
│ Rede                         │
│                              │
│ Docker                       │
│ hosts / atacante / target    │
└──────────────────────────────┘
A implementação ainda possui treinamento offline e execução em rede como etapas separadas.
Ou seja, o caminho atual é aproximadamente:
treinar
   ↓
salvar checkpoints
   ↓
executar na rede
O tráfego observado na rede ainda não retorna automaticamente ao ciclo de aprendizado.
E é justamente aí que começa a próxima etapa.
O que ainda falta?
O documento de planejamento que guiou essa revisão dividia a evolução em três fases:
consolidar
   ↓
fechar a arquitetura
   ↓
expandir a pesquisa
A v1.7 encerra principalmente a primeira. A próxima etapa é fechar de verdade a relação entre as três camadas.
Hoje conseguimos sair de features e chegar a pacotes.
O caminho futuro precisa também voltar dos pacotes para features:
Atacante
   ↓
Translator
   ↓
Sender
   ↓
Rede
   ↓
Captura
   ↓
Flow Extractor
   ↓
Defensor
Isso exige substituir ou complementar a bridge atual com uma infraestrutura que permita observar e controlar o tráfego com mais precisão.
A ideia continua sendo utilizar Open vSwitch e uma camada de controle capaz de reunir componentes como Traffic Monitor, Flow Extractor, integração com o Defensor, Rule Enforcer e coleta de métricas.
O Flow Extractor é provavelmente uma das partes mais delicadas.
Não basta capturar pacotes e gerar 77 números com nomes parecidos com os do dataset. As features reconstruídas precisam manter uma semântica compatível com aquelas usadas durante o treinamento.
Depois da inferência, o Rule Enforcer poderá transformar a decisão do Defensor em uma ação concreta na rede, inicialmente com respostas simples, como permitir ou bloquear fluxos.
O fluxo pretendido fica mais próximo de:
Atacante
   ↓
Open vSwitch
   ↓
Traffic Monitor
   ↓
Flow Extractor
   ↓
Defensor
   ↓
Rule Enforcer
   ↓
Open vSwitch
Mas ainda falta uma etapa além disso.
Fechar o feedback
Mesmo com monitoramento e resposta, a defesa só se torna realmente adaptativa em rede quando o que é observado pode voltar para o processo de aprendizado.
Hoje o fluxo ainda é:
treinar
   ↓
congelar
   ↓
executar
A evolução pretendida é algo mais próximo de:
observar
   ↓
detectar
   ↓
aprender
   ↓
validar
   ↓
atualizar
   ↓
observar novamente
O ponto importante aqui é validar.
Um novo checkpoint não deveria substituir automaticamente o modelo anterior apenas porque foi retreinado. Antes disso, ele precisa ser comparado para verificar se a adaptação não degradou o desempenho, introduziu catastrophic forgetting ou aprendeu com dados incorretos.
Essa preocupação é uma consequência direta da ideia de tratar a arquitetura como ferramenta experimental, e não apenas como uma demo de aprendizado online.
Depois de fechar o ciclo
Outras ideias continuam no roadmap, mas fazem mais sentido depois que a infraestrutura básica estiver completa.
Entre elas estão testar variantes inéditas de DDoS, avaliar generalização entre datasets, utilizar outras estratégias adversariais, substituir os modelos atuais, experimentar outros tipos de ataque e explorar cenários com honeypots e cyber deception.
Também existem melhorias de engenharia que não são prioridade científica, mas podem tornar a ferramenta mais utilizável: uma configuração realmente centralizada, redução adicional das responsabilidades do Controller, interfaces mais explícitas entre componentes, CI e uma CLI mais completa — provavelmente um menu interativo para configurar e executar experimentos sem depender apenas dos subcomandos atuais.
A ideia é que essas extensões não transformem cada novo experimento em uma nova arquitetura.
Idealmente, a ADArena deveria permitir substituir componentes mantendo o restante do ambiente.
Conclusão
O objetivo da v1.7 foi transformar a primeira implementação em algo que possa ser usado para produzir experimentos mais confiáveis, reproduzíveis e observáveis.
Usamos como base perguntas mais fundamentais, como:
- Os dados estão realmente isolados?
- O resultado pode ser reproduzido?
- O defensor melhorou contra qual atacante?
- Uma evasão matemática ainda representa algo traduzível?
- O Sender produziu aquilo que foi solicitado?
- Uma execução pode ser recuperada depois sem sobrescrever outra?
Olhando (novamente) em perspectiva, pensar nessa arquitetura como uma ferramenta que pode ser usada por qualquer pessoa, fez toda a diferença.
A próxima etapa técnica é fechar o ciclo entre rede, controle e aprendizado. Antes disso, entretanto, ainda existe outra coisa que quero fazer.
Agora que a v1.x está consolidada e conseguimos executar um treinamento completo, dry-runs e tráfego real, vale olhar para os resultados produzidos e perguntar:
O que eles realmente demonstram sobre defesa adaptativa?
E, talvez mais importante para o rumo atual da IC:
O que esses resultados dizem sobre a própria arquitetura como ferramenta experimental?
Esse será o assunto do próximo post. Até lá, se cuidem e bebam água (é sério, tá muito quente).
Referênicas
- Link para o repositório: github